Imaginez qu’un salarié demande à ChatGPT : "Peux-tu me préparer une présentation de notre société pour un prospect dans le secteur de l’assurance ?"
L'IA connaît peut-être votre société. Selon les outils et le contexte dont elle dispose, elle peut aussi trouver des informations sur Internet ou s’appuyer sur de précédentes conversations. Mais rien ne garantit que ces informations soient complètes, exactes ou à jour. C’est ce qui rend l’exercice risqué : l’IA pourrait produire une réponse parfaitement crédible à partir d’informations incomplètes ou fausses.
Il s’agit ici avant tout d’un problème de contexte. Pour être utile, les IA utilisées par les salariés et les partenaires doivent pouvoir s’appuyer sur une connaissance que l’entreprise a elle-même produite/collectée, contrôlée et validée.
Mon objectif dans cet article est de montrer comment mettre en place cette source de vérité et la rendre accessible aux équipes, aux partenaires et aux IA.
Étape 1 : construire une source de vérité de l’entreprise
L’idée est de s’appuyer sur le format Open Knowledge Format (OKF). Ce standard créé par Google permet de représenter la connaissance de manière structurée et lisible par les humains comme par les IA. Cela se fait simplement en écrivant des fichiers Markdown enrichis de métadonnées structurées.
L’objectif est que la connaissance ne soit pas prisonnière d’un logiciel, d’une base vectorielle ou d’un fournisseur d’IA. Elle est créée dans des fichiers Markdown par trois types d’acteurs.
1) Les humains
Une partie de la connaissance de l’entreprise ne peut venir que des personnes qui la connaissent. L’équipe marketing peut par exemple décrire le positionnement, les produits, les services, les messages, les personas… La direction technique peut documenter l’architecture technique, les API, les flux de données, les processus de développement… L’équipe RH peut présenter la culture, les valeurs, les processus RH… Et ainsi de suite.
2) Les systèmes informatiques
Une partie de la connaissance existe déjà dans les outils de l’entreprise : CRM, ERP, entrepôt de données, etc.
Plutôt que de recopier ces informations à la main, les systèmes peuvent générer automatiquement des fichiers OKF. Par exemple, un traitement périodique peut produire un concept contenant le chiffre d’affaires, le nombre de ventes ou la marge à partir des données existantes.
3) Les intelligences artificielles
Enfin, les IA peuvent elles-mêmes contribuer à ces connaissances en produisant des synthèses sur les concurrents, les évolutions réglementaires ou les principaux articles publiés par la presse spécialisée.
Une information produite par une IA n’a cependant pas nécessairement la même valeur qu’une information validée par la direction financière ou générée directement à partir de l’ERP. Il est donc essentiel de conserver sa provenance : qui ou quoi a produit l’information, à partir de quelles sources, quand elle a été produite et, le cas échéant, comment elle a été vérifiée.
Note: c’est justement l’un des apports importants de la version 0.2 d’OKF, qui permet d’associer aux concepts des informations de provenance, des sources et des signaux de confiance. Une IA qui consomme cette connaissance peut ainsi faire la différence entre un chiffre provenant directement d’un système comptable, une information validée par un humain et une synthèse produite automatiquement par une autre IA.
Étape 2 : publier la source de vérité de l’entreprise
Une fois que la source de vérité est construite, il faut la rendre accessible à toutes les parties prenantes de l’entreprise : salariés, partenaires, clients, fournisseurs… et bien sûr aux IA.
1) Un site pour les humains… et les IA
Avec Kiso CLI et un serveur d’intégration continue, nous générons automatiquement un site web statique à partir des fichiers Markdown du dépôt. Ce site est à la fois lisible par les humains et exploitable par les IA. Il permet de naviguer dans la connaissance, d’effectuer des recherches, de consulter les documents et de suivre les liens entre les différents concepts.
Une version publique du site est déployée sur Internet, accessible aux visiteurs, aux moteurs de recherche et aux IA. Une autre version, plus complète, est déployée sur l’intranet de l’entreprise. Le choix des contenus publiés permet de distinguer les informations publiques de celles réservées à un usage interne. Voici un exemple de site web généré pour la société Scub : www.scub.net/okf. Le site contient à la fois une version HTML pour les humains et une version Markdown pour les IA.
2) Un serveur MCP pour les IA
Publier un site web est utile pour les humains et permet déjà aux IA d’accéder à une information structurée et publiquement accessible. Ce contenu peut également être indexé par les moteurs de recherche et, potentiellement, être utilisé à l’avenir dans des jeux de données d’entraînement pour les IA.
Mais, dans leur travail quotidien, les salariés utilisent surtout des assistants comme ChatGPT ou Claude. Nous avons donc déployé Kiso MCP, un serveur compatible avec OFK et le Model Context Protocol (MCP), un protocole qui permet aux applications d’IA d’accéder à des outils et à des sources d’information externes.
Dans notre cas, Kiso MCP donne à l’assistant utilisé par le salarié un accès direct à la base de connaissances de l’entreprise. Lorsqu’il en a besoin pour répondre à une question, analyser un sujet ou produire un document, il peut rechercher et consulter les informations pertinentes à la source.
Une fois l'assistant de son choix connecté au serveur MCP de son entreprise, le salarié peut ensuite demander :
Peux-tu préparer une présentation de notre société pour un prospect dans le secteur de l’assurance ?
Au lieu de répondre uniquement à partir des informations apprises lors de son entraînement ou trouvées sur Internet, l’IA dispose alors d’une source supplémentaire : la connaissance produite et publiée par l’entreprise elle-même. Elle peut rechercher le positionnement de l’entreprise, ses offres, ses références, ses technologies ou ses éléments de langage avant de construire sa réponse.
Autre exemple, un développeur pourrait demander :
Quelle technologie devons-nous utiliser pour développer une nouvelle API Java ?
L’IA pourrait consulter les choix d’architecture documentés par la direction technique avant de répondre.
Un nouveau salarié pourrait demander :
Comment fonctionne notre politique de télétravail ?
L’IA pourrait rechercher la documentation produite et maintenue par les ressources humaines. Et un dirigeant pourrait demander :
Quel était notre chiffre d’affaires le mois dernier et comment a-t-il évolué depuis le début de l’année ?
L’IA pourrait retrouver les concepts produits automatiquement par les systèmes décisionnels de l’entreprise. Dans chacun de ces exemples, le modèle d’IA reste le même. Ce qui change, c’est le contexte qu’on lui donne.
Architecture
L’architecture complète peut alors se résumer ainsi :
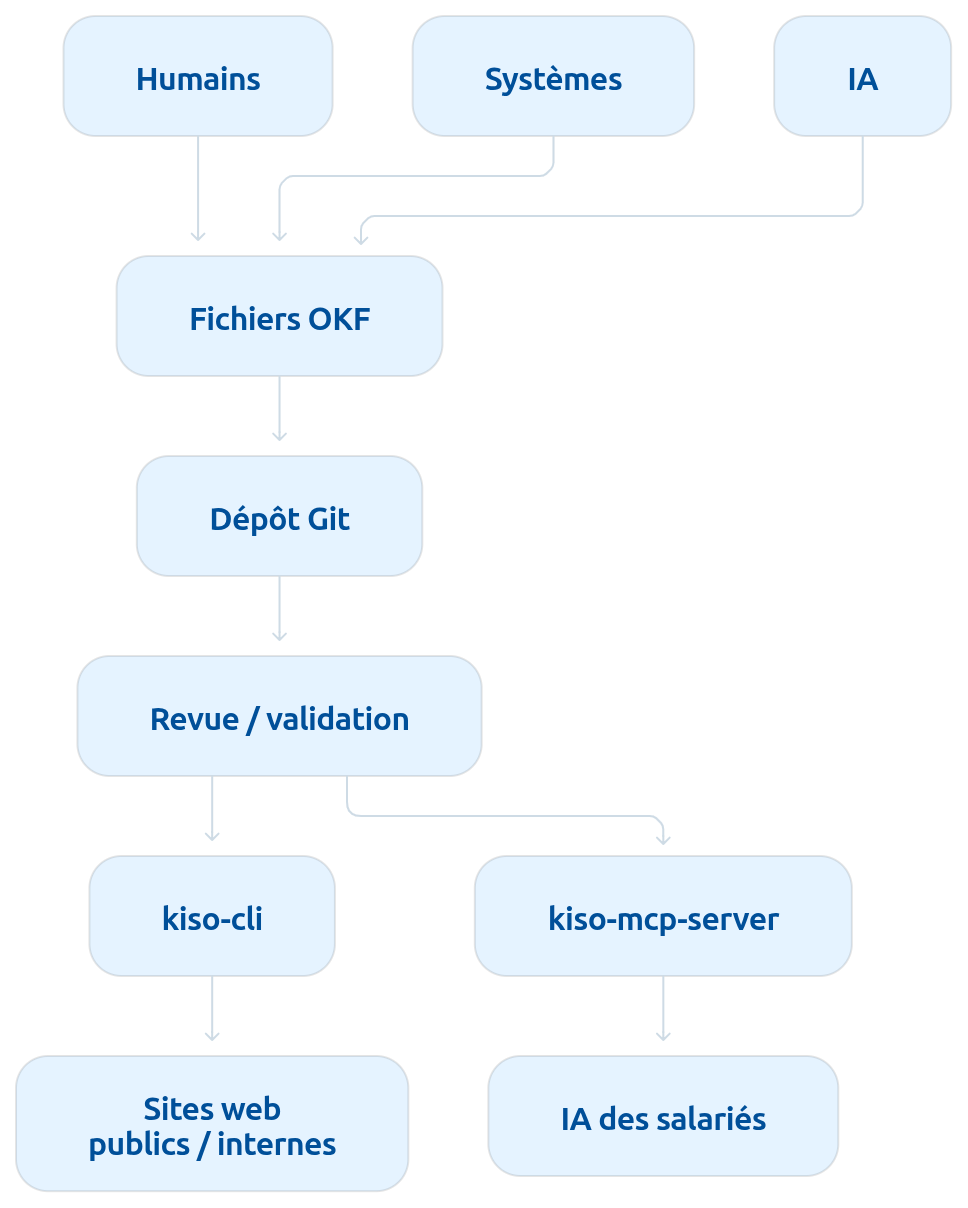
- Les humains, les programmes et les IA deviennent des producteurs de connaissance.
- OKF fournit un format commun pour représenter cette connaissance.
- Git permet de la versionner et d’organiser sa validation.
- Kiso permet ensuite de la publier à destination des humains ou de la rendre directement accessible aux IA.
L’entreprise doit posséder et gérer sa connaissance
La connaissance reste indépendante du fournisseur d’IA. Nous conservons la source de vérité de l’entreprise dans des fichiers Markdown que nous possédons, que nous pouvons lire, versionner, sauvegarder et utiliser avec n’importe quel outil.
ChatGPT peut utiliser ces connaissances aujourd’hui. Une autre IA pourra les utiliser demain. Le modèle apporte ses capacités de compréhension, de raisonnement et de génération. L’entreprise apporte le contexte. C’est, selon moi, l’un des grands enjeux de l’IA en entreprise.